Java 精选面试题 (持续更新)
Java 基础
为什么 HashMap 是线程不安全的?
在 jdk1.8 中,在多线程环境下,会发生数据覆盖的情况。
jdk1.8 中 HashMap
在 jdk1.8 中对 HashMap 进行了优化,在发生 hash 碰撞,不再采用头插法方式,而是直接插入链表尾部,因此不会出现环形链表的情况,但是在多线程的情况下仍然不安全,这里我们看 jdk1.8 中 HashMap 的 put 操作源码:
1 | |
这是 jdk1.8 中 HashMap 中 put 操作的主函数, 注意第 6 行代码,如果没有 hash 碰撞则会直接插入元素。如果线程 A 和线程 B 同时进行 put 操作,刚好这两条不同的数据 hash 值一样,并且该位置数据为 null,所以这线程 A、B 都会进入第 6 行代码中。
假设一种情况,线程 A 进入后还未进行数据插入时挂起,而线程 B 正常执行,从而正常插入数据,然后线程 A 获取 CPU 时间片,此时线程 A 不用再进行 hash 判断了,问题出现:线程 A 会把线程 B 插入的数据给覆盖,发生线程不安全。
单例模式一共有几种写法?
大体可分为 4 类,下面分别介绍他们的基本形式、变种及特点。
饱汉模式
饱汉是变种最多的单例模式。我们从饱汉出发,通过其变种逐渐了解实现单例模式时需要关注的问题。
基础的饱汉
饱汉,即已经吃饱,不着急再吃,饿的时候再吃。所以他就先不初始化单例,等第一次使用的时候再初始化,即“懒加载”。
1 | |
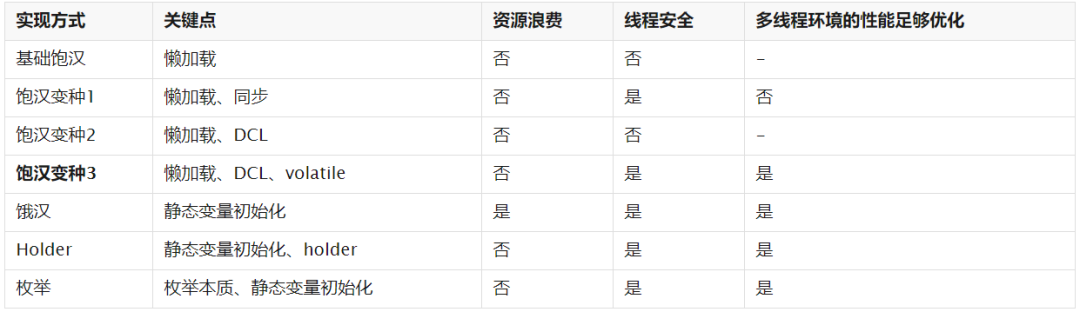
饱汉模式的核心就是懒加载。好处是更启动速度快、节省资源,一直到实例被第一次访问,才需要初始化单例;小坏处是写起来麻烦,大坏处是线程不安全,if 语句存在竞态条件。
写起来麻烦不是大问题,可读性好啊。因此,单线程环境下,基础饱汉是笔者最喜欢的写法。但多线程环境下,基础饱汉就彻底不可用了。下面的几种变种都在试图解决基础饱汉线程不安全的问题。
饱汉 - 变种 1
最粗暴的犯法是用 synchronized 关键字修饰 getInstance()方法,这样能达到绝对的线程安全。
1 | |
变种 1 的好处是写起来简单,且绝对线程安全;坏处是并发性能极差,事实上完全退化到了串行。单例只需要初始化一次,但就算初始化以后,synchronized 的锁也无法避开,从而 getInstance()完全变成了串行操作。性能不敏感的场景建议使用。
饱汉 - 变种 2
变种 2 是“臭名昭著”的 DCL 1.0。
针对变种 1 中单例初始化后锁仍然无法避开的问题,变种 2 在变种 1 的外层又套了一层 check,加上 synchronized 内层的 check,即所谓“双重检查锁”(Double Check Lock,简称 DCL)。
1 | |
变种 2 的核心是 DCL,看起来变种 2 似乎已经达到了理想的效果:懒加载+线程安全。可惜的是,正如注释中所说,DCL 仍然是线程不安全的,由于指令重排序,你可能会得到“半个对象”,即”部分初始化“问题。详细在看完变种 3 后,可参考下面这篇文章,这里不再赘述。
饱汉 - 变种 3
变种 3 专门针对变种 2,可谓 DCL 2.0。
针对变种 3 的“半个对象”问题,变种 3 在 instance 上增加了 volatile 关键字,原理见上述参考。
1 | |
多线程环境下,变种 3 更适用于性能敏感的场景。但后面我们将了解到,就算是线程安全的,还有一些办法能破坏单例。
当然,还有很多方式,能通过与 volatile 类似的方式防止部分初始化。读者可自行阅读内存屏障相关内容,但面试时不建议主动装逼。
饿汉模式
与饱汉相对,饿汉很饿,只想着尽早吃到。所以他就在最早的时机,即类加载时初始化单例,以后访问时直接返回即可。
1 | |
饿汉的好处是天生的线程安全(得益于类加载机制),写起来超级简单,使用时没有延迟;坏处是有可能造成资源浪费(如果类加载后就一直不使用单例的话)。
值得注意的时,单线程环境下,饿汉与饱汉在性能上没什么差别;但多线程环境下,由于饱汉需要加锁,饿汉的性能反而更优。
Holder 模式
我们既希望利用饿汉模式中静态变量的方便和线程安全;又希望通过懒加载规避资源浪费。Holder 模式满足了这两点要求:核心仍然是静态变量,足够方便和线程安全;通过静态的 Holder 类持有真正实例,间接实现了懒加载。
1 | |
相对于饿汉模式,Holder 模式仅增加了一个静态内部类的成本,与饱汉的变种 3 效果相当(略优),都是比较受欢迎的实现方式。同样建议考虑。
枚举模式
用枚举实现单例模式,相当好用,但可读性是不存在的。
基础的枚举
将枚举的静态成员变量作为单例的实例:
1 | |
代码量比饿汉模式更少。但用户只能直接访问实例 Singleton4.SINGLETON——事实上,这样的访问方式作为单例使用也是恰当的,只是牺牲了静态工厂方法的优点,如无法实现懒加载。
丑陋但好用的语法糖
Java 的枚举是一个“丑陋但好用的语法糖”。
枚举型单例模式的本质
通过反编译打开语法糖,就看到了枚举类型的本质,简化如下:
1 | |
本质上和饿汉模式相同,区别仅在于公有的静态成员变量。
用枚举实现一些 trick
这一部分与单例没什么关系,可以跳过。如果选择阅读也请认清这样的事实:虽然枚举相当灵活,但如何恰当的使用枚举有一定难度。一个足够简单的典型例子是 TimeUnit 类,建议有时间耐心阅读。
上面已经看到,枚举型单例的本质仍然是一个普通的类。实际上,我们可以在枚举型型单例上增加任何普通类可以完成的功能。要点在于枚举实例的初始化,可以理解为实例化了一个匿名内部类。为了更明显,我们在 Singleton4_1 中定义一个普通的私有成员变量,一个普通的公有成员方法,和一个公有的抽象成员方法,如下:
1 | |
这样,枚举类 Singleton4_1 中的每一个枚举实例不仅继承了父类 Singleton4_1 的成员方法 print(),还必须实现父类 Singleton4_1 的抽象成员方法 testAbsMethod()。
总结
上面的分析都忽略了反射和序列化的问题。通过反射或序列化,我们仍然能够访问到私有构造器,创建新的实例破坏单例模式。此时,只有枚举模式能天然防范这一问题。反射和序列化笔者还不太了解,但基本原理并不难,可以在其他模式上手动实现。
下面继续忽略反射和序列化的问题,做个总结回味一下:
你能说说进程与线程的区别吗
两者的定义
进程是具有一定独立功能的程序关于某个数据集合上的一次运行活动,进程是系统进行资源分配和调度的一个独立单位。
线程是进程的一个实体,是 CPU 调度和分派的基本单位,它是比进程更小的能独立运行的基本单位.线程自己基本上不拥有系统资源,只拥有一点在运行中必不可少的资源(如程序计数器,一组寄存器和栈),但是它可与同属一个进程的其他的线程共享进程所拥有的全部资源。
进程与线程的区别
- 进程是资源分配最小单位,线程是程序执行的最小单位;
- 进程有自己独立的地址空间,每启动一个进程,系统都会为其分配地址空间,建立数据表来维护代码段、堆栈段和数据段,线程没有独立的地址空间,它使用相同的地址空间共享数据;
- CPU 切换一个线程比切换进程花费小;
- 创建一个线程比进程开销小;
- 线程占用的资源要⽐进程少很多。
- 线程之间通信更方便,同一个进程下,线程共享全局变量,静态变量等数据,进程之间的通信需要以通信的方式(IPC)进行;(但多线程程序处理好同步与互斥是个难点)
- 多进程程序更安全,生命力更强,一个进程死掉不会对另一个进程造成影响(源于有独立的地址空间),多线程程序更不易维护,一个线程死掉,整个进程就死掉了(因为共享地址空间);
- 进程对资源保护要求高,开销大,效率相对较低,线程资源保护要求不高,但开销小,效率高,可频繁切换;
创建线程有几种不同的方式?你喜欢哪一种?为什么?
有三种方式可以用来创建线程:
- 继承 Thread 类
- 实现 Runnable 接口
- 应用程序可以使用 Executor 框架来创建线程池
实现 Runnable 接口这种方式更受欢迎,因为这不需要继承 Thread 类。在应用设计中已经继承了别的对象的情况下,这需要多继承(而 Java 不支持多继承),只能实现接口。同时,线程池也是非常高效的,很容易实现和使用。
概括的解释下线程的几种可用状态。
新建( new ):新创建了一个线程对象;
可运行( runnable ):线程对象创建后,其他线程(比如 main 线程)调用了该对象的 start ()方法。该状态的线程位于可运行线程池中,等待被线程调度选中,获 取 CPU 的使用权;
运行( running ):可运行状态( runnable )的线程获得了 CPU 时间片( timeslice ) ,执行程序代码;
阻塞( block ):阻塞状态是指线程因为某种原因放弃了 CPU 使用权,也即让出了 CPU timeslice ,暂时停止运行。直到线程进入可运行( runnable )状态,才有 机会再次获得 cpu timeslice 转到运行( running )状态。
阻塞的情况分三种:
- 等待阻塞:运行( running )的线程执行 o . wait ()方法, JVM 会把该线程放 入等待队列( waitting queue )中。
- 同步阻塞:运行( running )的线程在获取对象的同步锁时,若该同步锁被别的线程占用,则 JVM 会把该线程放入锁池( lock pool )中。
- 其他阻塞: 运行( running )的线程执行 Thread . sleep ( long ms )或 t . join ()方法,或者发出了 I / O 请求时, JVM 会把该线程置为阻塞状态。当 sleep ()状态超时、 join ()等待线程终止或者超时、或者 I / O 处理完毕时,线程重新转入可运行( runnable )状态。
死亡( dead ):线程 run ()、 main () 方法执行结束,或者因异常退出了 run ()方法,则该线程结束生命周期。死亡的线程不可再次复生。
同步方法和同步代码块的区别是什么?
区别:
- 同步方法默认用 this 或者当前类 class 对象作为锁;
- 同步代码块可以选择以什么来加锁,比同步方法要更细颗粒度,我们可以选择只同步会发生同步问题的部分代码而不是整个方法;
在监视器(Monitor)内部,是如何做线程同步的?程序应该做哪种级别的同步?
监视器和锁在 Java 虚拟机中是一块使用的。监视器监视一块同步代码块,确保一次只有一个线程执行同步代码块。每一个监视器都和一个对象引用相关联。线程在获取锁之前不允许执行同步代码。
java 还提供了显式监视器( Lock )和隐式监视器( synchronized )两种锁方案。
什么是死锁(deadlock)?
两个线程或两个以上线程都在等待对方执行完毕才能继续往下执行的时候就发生了死锁。结果就是这些线程都陷入了无限的等待中。
如何确保 N 个线程可以访问 N 个资源同时又不导致死锁?
多线程产生死锁的四个必要条件:
- 互斥条件:一个资源每次只能被一个进程使用。
- 保持和请求条件:一个进程因请求资源而阻塞时,对已获得资源保持不放。
- 不可剥夺性:进程已获得资源,在未使用完成前,不能被剥夺。
- 循环等待条件(闭环):若干进程之间形成一种头尾相接的循环等待资源关系。
只要破坏其中任意一个条件,就可以避免死锁
一种非常简单的避免死锁的方式就是:指定获取锁的顺序,并强制线程按照指定的顺序获取锁。因此,如果所有的线程都是以同样的顺序加锁和释放锁,就不会出现死锁了。
Java 序列化与反序列化三连问:是什么?为什么要?如何做?
Java 序列化与反序列化是什么?
Java 序列化是指把 Java 对象转换为字节序列的过程,而 Java 反序列化是指把字节序列恢复为 Java 对象的过程:
- 序列化:对象序列化的最主要的用处就是在传递和保存对象的时候,保证对象的完整性和可传递性。序列化是把对象转换成有序字节流,以便在网络上传输或者保存在本地文件中。核心作用是对象状态的保存与重建。
- 反序列化:客户端从文件中或网络上获得序列化后的对象字节流,根据字节流中所保存的对象状态及描述信息,通过反序列化重建对象。
为什么需要序列化与反序列化?
为什么要序列化,那就是说一下序列化的好处喽,序列化有什么什么优点,所以我们要序列化。
一:对象序列化可以实现分布式对象。
主要应用例如:RMI(即远程调用 Remote Method Invocation)要利用对象序列化运行远程主机上的服务,就像在本地机上运行对象时一样。
二:java 对象序列化不仅保留一个对象的数据,而且递归保存对象引用的每个对象的数据。
可以将整个对象层次写入字节流中,可以保存在文件中或在网络连接上传递。利用对象序列化可以进行对象的”深复制”,即复制对象本身及引用的对象本身。序列化一个对象可能得到整个对象序列。
三:序列化可以将内存中的类写入文件或数据库中。
比如:将某个类序列化后存为文件,下次读取时只需将文件中的数据反序列化就可以将原先的类还原到内存中。也可以将类序列化为流数据进行传输。
总的来说就是将一个已经实例化的类转成文件存储,下次需要实例化的时候只要反序列化即可将类实例化到内存中并保留序列化时类中的所有变量和状态。
四:对象、文件、数据,有许多不同的格式,很难统一传输和保存。
序列化以后就都是字节流了,无论原来是什么东西,都能变成一样的东西,就可以进行通用的格式传输或保存,传输结束以后,要再次使用,就进行反序列化还原,这样对象还是对象,文件还是文件。
如何实现 Java 序列化与反序列化?
首先我们要把准备要序列化类,实现 Serializabel 接口
例如:我们要 Person 类里的 name 和 age 都序列化
1 | |
然后:我们将 name 和 age 序列化(也就是把这 2 个对象转为二进制,理解为“打碎”)
1 | |
《Java 对象的序列化(Serialization)和反序列化详解》
https://blog.csdn.net/yaomingyang/article/details/79321939
《Java 序列化的高级认识》
https://www.ibm.com/developerworks/cn/java/j-lo-serial/
什么情况用ArrayList or LinkedList呢?
列表(list)是元素的有序集合,也称为序列。它提供了基于元素位置的操作,有助于快速访问、添加和删除列表中特定索引位置的元素。List 接口实现了 Collection 和 Iterable 作为父接口。它允许存储重复值和空值,支持通过索引访问元素。
ArrayList 和 LinkedList 的不同之处
增加元素到列表尾端
在 ArrayList 中增加元素到队列尾端的代码如下:
1 | |
ArrayList中 add() 方法的性能决定于ensureCapacity()方法。ensureCapacity()的实现如下:
1 | |
可以看到,只要ArrayList的当前容量足够大,a dd()操作的效率非常高的。只有当ArrayList对容量的需求超出当前数组大小时,才需要进行扩容。扩容的过程中,会进行大量的数组复制操作。而数组复制时,最终将调用System.arraycopy()方法,因此add()操作的效率还是相当高的。
LinkedList 的add()操作实现如下,它也将任意元素增加到队列的尾端:
1 | |
其中addBefore()的方法实现如下:
1 | |
可见,LinkeList由于使用了链表的结构,因此不需要维护容量的大小。从这点上说,它比ArrayList有一定的性能优势,然而,每次的元素增加都需要新建一个Entry对象,并进行更多的赋值操作。在频繁的系统调用中,对性能会产生一定的影响。
增加元素到列表任意位置
除了提供元素到List的尾端,List接口还提供了在任意位置插入元素的方法:void add(int index,E element);
由于实现的不同,ArrayList和LinkedList在这个方法上存在一定的性能差异,由于ArrayList是基于数组实现的,而数组是一块连续的内存空间,如果在数组的任意位置插入元素,必然导致在该位置后的所有元素需要重新排列,因此,其效率相对会比较低。
以下代码是ArrayList中的实现:
1 | |
可以看到每次插入操作,都会进行一次数组复制。而这个操作在增加元素到List尾端的时候是不存在的,大量的数组重组操作会导致系统性能低下。并且插入元素在List中的位置越是靠前,数组重组的开销也越大。
而LinkedList此时显示了优势:
1 | |
可见,对LinkedList来说,在List的尾端插入数据与在任意位置插入数据是一样的,不会因为插入的位置靠前而导致插入的方法性能降低。
删除任意位置元素
对于元素的删除,List接口提供了在任意位置删除元素的方法:
1 | |
对ArrayList来说,remove()方法和add()方法是雷同的。在任意位置移除元素后,都要进行数组的重组。ArrayList的实现如下:
1 | |
可以看到,在ArrayList的每一次有效的元素删除操作后,都要进行数组的重组。并且删除的位置越靠前,数组重组时的开销越大。
1 | |
在LinkedList的实现中,首先要通过循环找到要删除的元素。如果要删除的位置处于List的前半段,则从前往后找;若其位置处于后半段,则从后往前找。因此无论要删除较为靠前或者靠后的元素都是非常高效的;但要移除List中间的元素却几乎要遍历完半个List,在List拥有大量元素的情况下,效率很低。
容量参数
容量参数是ArrayList和Vector等基于数组的List的特有性能参数。它表示初始化的数组大小。当ArrayList所存储的元素数量超过其已有大小时。它便会进行扩容,数组的扩容会导致整个数组进行一次内存复制。因此合理的数组大小有助于减少数组扩容的次数,从而提高系统性能。
1 | |
ArrayList提供了一个可以制定初始数组大小的构造函数:
1 | |
现以构造一个拥有100万元素的List为例,当使用默认初始化大小时,其消耗的相对时间为125ms左右,当直接制定数组大小为100万时,构造相同的ArrayList仅相对耗时16ms。
遍历列表
遍历列表操作是最常用的列表操作之一,在JDK1.5之后,至少有3中常用的列表遍历方式:
- forEach操作
- 迭代器
- for循环。
1 | |
构造一个拥有100万数据的ArrayList和等价的LinkedList,使用以上代码进行测试,测试结果:
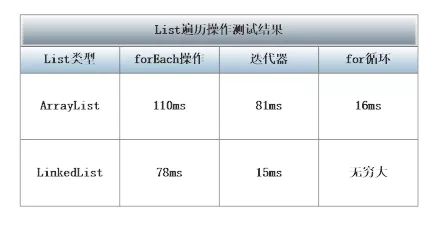
可以看到,最简便的ForEach循环并没有很好的性能表现,综合性能不如普通的迭代器,而是用for循环通过随机访问遍历列表时,ArrayList表项很好,但是LinkedList的表现却无法让人接受,甚至没有办法等待程序的结束。这是因为对LinkedList进行随机访问时,总会进行一次列表的遍历操作。性能非常差,应避免使用。
Java 进阶
你能说说 Spring 框架中 Bean 的生命周期吗?
实例化一个
Bean, 也就是我们常说的new;按照
Spring上下文对实例化的Bean进行配置--也就是IOC注入;如果这个
Bean已经实现了BeanNameAware接口,会调用它实现的setBeanName(String)方法,此处传递的就是Spring配置文件中Bean的id值如果这个
Bean已经实现了BeanFactoryAware接口,会调用它实现的setBeanFactory(setBeanFactory(BeanFactory)传递的是 Spring 工厂自身(可以用这个方式来获取其它 Bean,只需在 Spring 配置文件中配置一个普通的 Bean 就可以);如果这个
Bean已经实现了ApplicationContextAware接口,会调用setApplicationContext(ApplicationContext)方法,传入 Spring 上下文(同样这个方式也可以实现步骤 4 的内容,但比 4 更好,因为ApplicationContext是BeanFactory的子接口,有更多的实现方法);如果这个
Bean关联了BeanPostProcessor接口,将会调用postProcessBeforeInitialization(Object obj, String s)方法,BeanPostProcessor经常被用作是Bean内容的更改,并且由于这个是在Bean初始化结束时调用那个的方法,也可以被应用于内存或缓存技术;如果
Bean在Spring配置文件中配置了init-method属性会自动调用其配置的初始化方法。如果这个
Bean关联了BeanPostProcessor接口,将会调用postProcessAfterInitialization(Object obj, String s)方法、;注:以上工作完成以后就可以应用这个
Bean了,那这个Bean是一个Singleton的,所以一般情况下我们调用同一个id的Bean会是在内容地址相同的实例,当然在Spring配置文件中也可以配置非Singleton,这里我们不做赘述。当
Bean不再需要时,会经过清理阶段,如果Bean实现了DisposableBean这个接口,会调用那个其实现的destroy()方法;最后,如果这个
Bean的Spring配置中配置了destroy-method属性,会自动调用其配置的销毁方法。
Spring,SpringMVC,SpringBoot,SpringCloud 有什么区别和联系?
简单介绍
Spring是一个轻量级的控制反转(IoC)和面向切面(AOP)的容器框架。Spring 使你能够编写更干净、更可管理、并且更易于测试的代码。Spring MVC是 Spring 的一个模块,一个 web 框架。通过Dispatcher Servlet,ModelAndView和View Resolver,开发 web 应用变得很容易。主要针对的是网站应用程序或者服务开发——URL 路由、Session、模板引擎、静态 Web 资源等等。Spring配置复杂,繁琐,所以推出了Spring boot,约定优于配置,简化了 spring 的配置流程。Spring Cloud构建于Spring Boot之上,是一个关注全局的服务治理框架。
Spring VS SpringMVC
Spring是一个一站式的轻量级的 java 开发框架,核心是控制反转(IOC)和面向切面(AOP),针对于开发的 WEB 层 (springMvc)、业务层(Ioc)、持久层(jdbcTemplate)等都提供了多种配置解决方案;SpringMVC是Spring基础之上的一个MVC框架,主要处理web开发的路径映射和视图渲染,属于Spring框架中WEB层开发的一部分;
SpringMVC VS SpringBoot
SpringMVC属于一个企业 WEB 开发的 MVC 框架,涵盖面包括前端视图开发、文件配置、后台接口逻辑开发等,XML、config 等配置相对比较繁琐复杂;SpringBoot框架相对于 SpringMVC 框架来说,更专注于开发微服务后台接口,不开发前端视图;
SpringBoot VS SpringCloud
SpringBoot使用了默认大于配置的理念,集成了快速开发的Spring多个插件,同时自动过滤不需要配置的多余的插件,简化了项目的开发配置流程,一定程度上取消 xml 配置,是一套快速配置开发的脚手架,能快速开发单个微服务;SpringCloud大部分的功能插件都是基于SpringBoot去实现的,SpringCloud关注于全局的微服务整合和管理,将多个SpringBoot单体微服务进行整合以及管理;SpringCloud依赖于SpringBoot开发,而 -SpringBoot可以独立开发;
总结
- Spring 是核心,提供了基础功能;
- Spring MVC 是基于 Spring 的一个 MVC 框架 ;
- Spring Boot 是为简化 Spring 配置的快速开发整合包;
- Spring Cloud 是构建在 Spring Boot 之上的服务治理框架。
如何保证消息的顺序性?
面试官心理分析
其实这个也是用 MQ 的时候必问的话题,第一看看你了不了解顺序这个事儿?第二看看你有没有办法保证消息是有顺序的?这是生产系统中常见的问题。
面试题剖析
我举个例子,我们以前做过一个 mysql binlog 同步的系统,压力还是非常大的,日同步数据要达到上亿,就是说数据从一个 mysql 库原封不动地同步到另一个 mysql 库里面去(mysql -> mysql)。常见的一点在于说比如大数据 team,就需要同步一个 mysql 库过来,对公司的业务系统的数据做各种复杂的操作。
你在 mysql 里增删改一条数据,对应出来了增删改 3 条 binlog 日志,接着这三条 binlog 发送到 MQ 里面,再消费出来依次执行,起码得保证人家是按照顺序来的吧?不然本来是:增加、修改、删除;你楞是换了顺序给执行成删除、修改、增加,不全错了么。
本来这个数据同步过来,应该最后这个数据被删除了;结果你搞错了这个顺序,最后这个数据保留下来了,数据同步就出错了。
先看看顺序会错乱的俩场景:
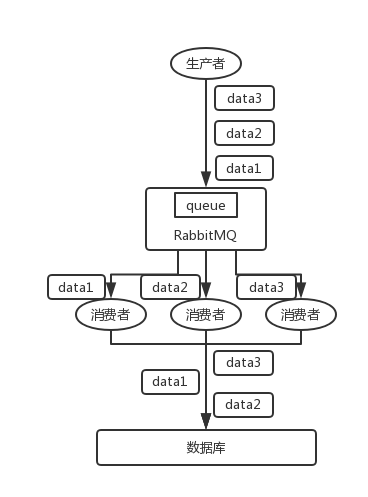
- RabbitMQ:一个 queue,多个 consumer。比如,生产者向 RabbitMQ 里发送了三条数据,顺序依次是 data1/data2/data3,压入的是 RabbitMQ 的一个内存队列。有三个消费者分别从 MQ 中消费这三条数据中的一条,结果消费者 2 先执行完操作,把 data2 存入数据库,然后是 data1/data3。这不明显乱了。
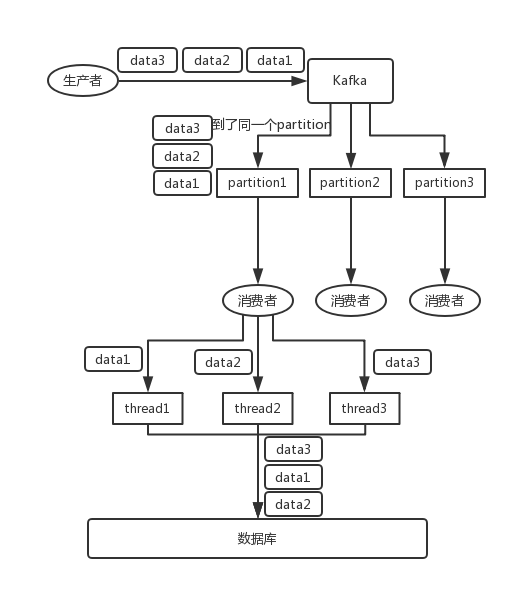
Kafka:比如说我们建了一个 topic,有三个 partition。生产者在写的时候,其实可以指定一个 key,比如说我们指定了某个订单 id 作为 key,那么这个订单相关的数据,一定会被分发到同一个 partition 中去,而且这个 partition 中的数据一定是有顺序的。
消费者从 partition 中取出来数据的时候,也一定是有顺序的。到这里,顺序还是 ok 的,没有错乱。接着,我们在消费者里可能会搞多个线程来并发处理消息。因为如果消费者是单线程消费处理,而处理比较耗时的话,比如处理一条消息耗时几十 ms,那么 1 秒钟只能处理几十条消息,这吞吐量太低了。而多个线程并发跑的话,顺序可能就乱掉了。
解决方案
RabbitMQ
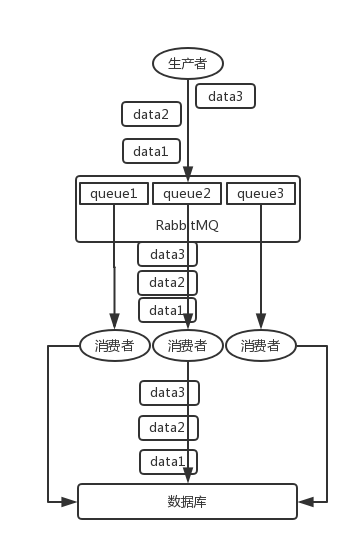
拆分多个 queue,每个 queue 一个 consumer,就是多一些 queue 而已,确实是麻烦点;或者就一个 queue 但是对应一个 consumer,然后这个 consumer 内部用内存队列做排队,然后分发给底层不同的 worker 来处理。
Kafka
- 一个 topic,一个 partition,一个 consumer,内部单线程消费,单线程吞吐量太低,一般不会用这个。
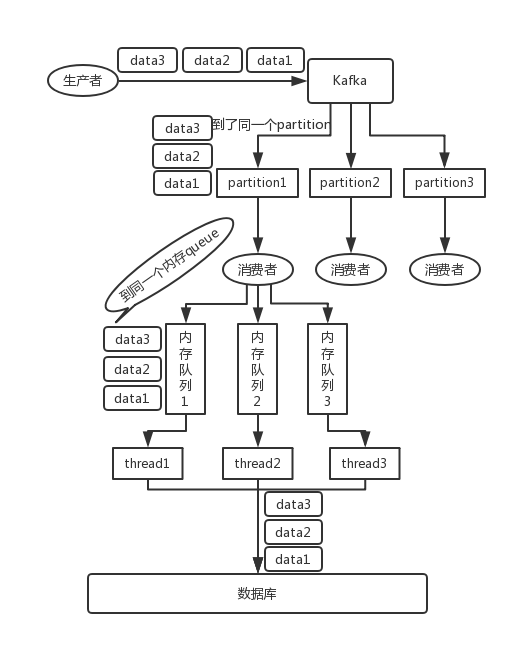
- 写 N 个内存 queue,具有相同 key 的数据都到同一个内存 queue;然后对于 N 个线程,每个线程分别消费一个内存 queue 即可,这样就能保证顺序性。
Redis
Redis 是如何实现分布式锁的?
分布式锁常见的三种实现方式:
- 数据库乐观锁;
- 基于 Redis 的分布式锁;
- 基于 ZooKeeper 的分布式锁。
本面试考点是,你对 Redis 使用熟悉吗?Redis 中是如何实现分布式锁的。
要点
Redis 要实现分布式锁,以下条件应该得到满足
互斥性
- 在任意时刻,只有一个客户端能持有锁。
不能死锁
- 客户端在持有锁的期间崩溃而没有主动解锁,也能保证后续其他客户端能加锁。
容错性
- 只要大部分的 Redis 节点正常运行,客户端就可以加锁和解锁。
实现
可以直接通过 set key value px milliseconds nx 命令实现加锁, 通过 Lua 脚本实现解锁。
1 | |
代码解释
- set 命令要用
set key value px milliseconds nx,替代setnx + expire需要分两次执行命令的方式,保证了原子性, - value 要具有唯一性,可以使用
UUID.randomUUID().toString()方法生成,用来标识这把锁是属于哪个请求加的,在解锁的时候就可以有依据; - 释放锁时要验证 value 值,防止误解锁;
- 通过 Lua 脚本来避免 Check And Set 模型的并发问题,因为在释放锁的时候因为涉及到多个 Redis 操作 (利用了 eval 命令执行 Lua 脚本的原子性);
加锁代码分析
首先,set()加入了 NX 参数,可以保证如果已有 key 存在,则函数不会调用成功,也就是只有一个客户端能持有锁,满足互斥性。其次,由于我们对锁设置了过期时间,即使锁的持有者后续发生崩溃而没有解锁,锁也会因为到了过期时间而自动解锁(即 key 被删除),不会发生死锁。最后,因为我们将 value 赋值为 requestId,用来标识这把锁是属于哪个请求加的,那么在客户端在解锁的时候就可以进行校验是否是同一个客户端。
解锁代码分析
将 Lua 代码传到 jedis.eval()方法里,并使参数 KEYS[1]赋值为 lockKey,ARGV[1]赋值为 requestId。在执行的时候,首先会获取锁对应的 value 值,检查是否与 requestId 相等,如果相等则解锁(删除 key)。
存在的风险
如果存储锁对应 key 的那个节点挂了的话,就可能存在丢失锁的风险,导致出现多个客户端持有锁的情况,这样就不能实现资源的独享了。
- 客户端 A 从 master 获取到锁
- 在 master 将锁同步到 slave 之前,master 宕掉了(Redis 的主从同步通常是异步的)。
主从切换,slave 节点被晋级为 master 节点 - 客户端 B 取得了同一个资源被客户端 A 已经获取到的另外一个锁。导致存在同一时刻存不止一个线程获取到锁的情况。
redlock 算法出现
这个场景是假设有一个 redis cluster,有 5 个 redis master 实例。然后执行如下步骤获取一把锁:
- 获取当前时间戳,单位是毫秒;
- 跟上面类似,轮流尝试在每个 master 节点上创建锁,过期时间较短,一般就几十毫秒;
- 尝试在大多数节点上建立一个锁,比如 5 个节点就要求是 3 个节点 n / 2 + 1;
- 客户端计算建立好锁的时间,如果建立锁的时间小于超时时间,就算建立成功了;
- 要是锁建立失败了,那么就依次之前建立过的锁删除;
- 只要别人建立了一把分布式锁,你就得不断轮询去尝试获取锁。
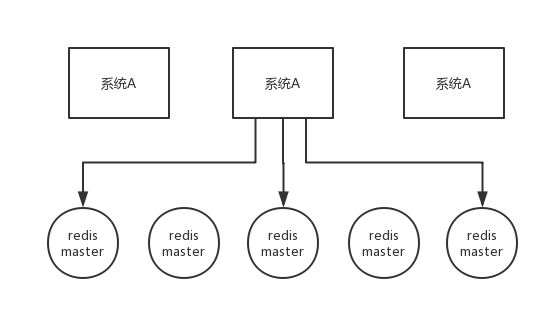
Redis 官方给出了以上两种基于 Redis 实现分布式锁的方法,详细说明可以查看:
Redisson 实现
Redisson 是一个在 Redis 的基础上实现的 Java 驻内存数据网格(In-Memory Data Grid)。它不仅提供了一系列的分布式的 Java 常用对象,还实现了可重入锁(Reentrant Lock)、公平锁(Fair Lock、联锁(MultiLock)、 红锁(RedLock)、 读写锁(ReadWriteLock)等,还提供了许多分布式服务。
Redisson 提供了使用 Redis 的最简单和最便捷的方法。Redisson 的宗旨是促进使用者对 Redis 的关注分离(Separation of Concern),从而让使用者能够将精力更集中地放在处理业务逻辑上。
Redisson 分布式重入锁用法
Redisson 支持单点模式、主从模式、哨兵模式、集群模式,这里以单点模式为例:
1 | |
加锁流程图
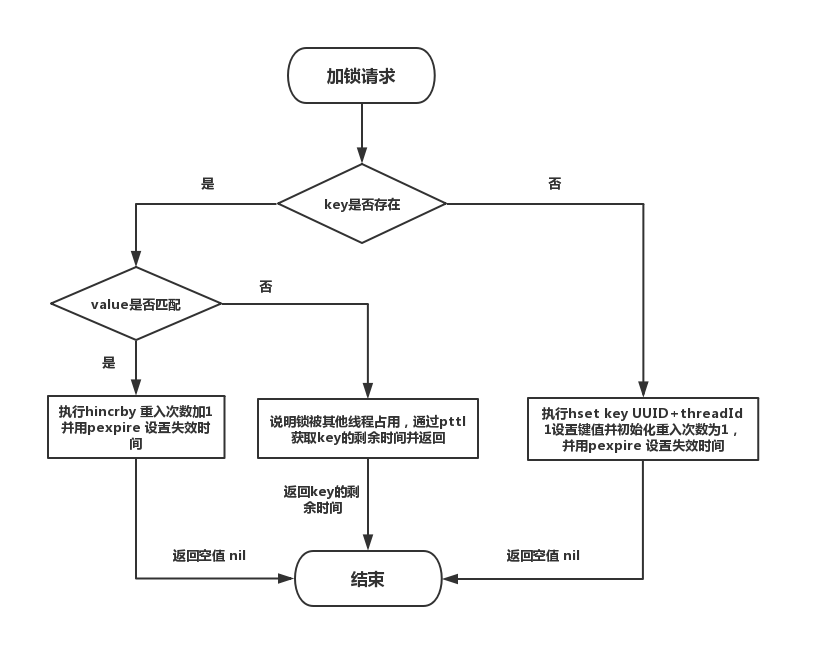
解锁流程图
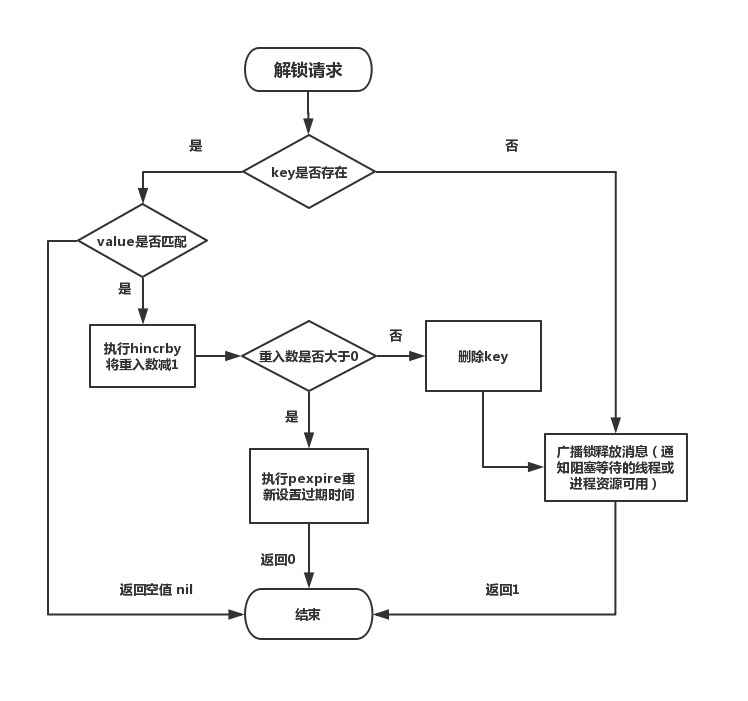
我们可以看到,RedissonLock 是可重入的,并且考虑了失败重试,可以设置锁的最大等待时间, 在实现上也做了一些优化,减少了无效的锁申请,提升了资源的利用率。
需要特别注意的是,RedissonLock 同样没有解决 节点挂掉的时候,存在丢失锁的风险的问题。而现实情况是有一些场景无法容忍的,所以 Redisson 提供了实现了 redlock 算法的 RedissonRedLock,RedissonRedLock 真正解决了单点失败的问题,代价是需要额外的为 RedissonRedLock 搭建 Redis 环境。
所以,如果业务场景可以容忍这种小概率的错误,则推荐使用 RedissonLock, 如果无法容忍,则推荐使用 RedissonRedLock。
Redis 面试常见问答
什么是缓存雪崩?怎么解决?
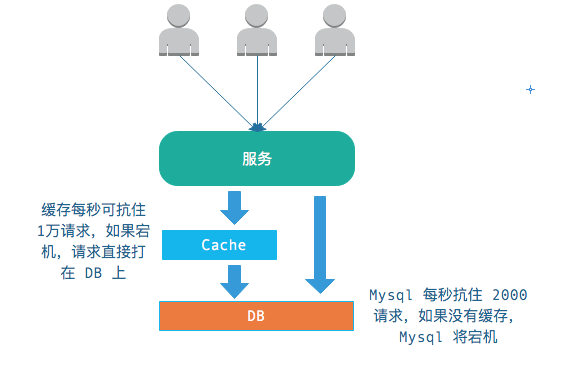
通常,我们会使用缓存用于缓冲对 DB 的冲击,如果缓存宕机,所有请求将直接打在 DB,造成 DB 宕机——从而导致整个系统宕机。
如何解决呢?
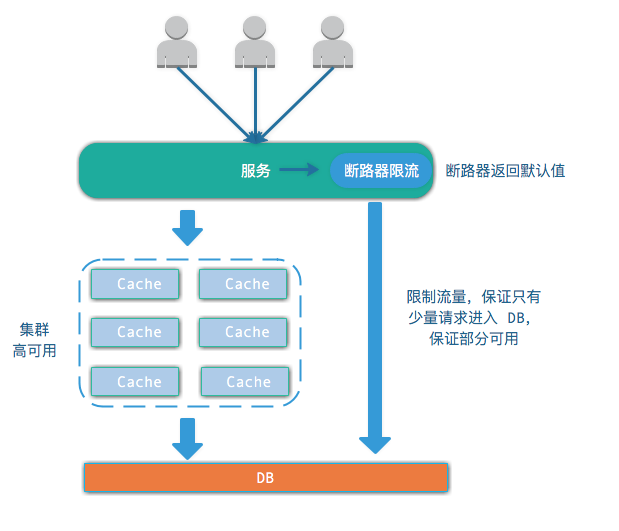
2 种策略(同时使用):
- 对缓存做高可用,防止缓存宕机
- 使用断路器,如果缓存宕机,为了防止系统全部宕机,限制部分流量进入 DB,保证部分可用,其余的请求返回断路器的默认值。
什么是缓存穿透?怎么解决?
解释 1:缓存查询一个没有的 key,同时数据库也没有,如果黑客大量的使用这种方式,那么就会导致 DB 宕机。
解决方案:我们可以使用一个默认值来防止,例如,当访问一个不存在的 key,然后再去访问数据库,还是没有,那么就在缓存里放一个占位符,下次来的时候,检查这个占位符,如果发生时占位符,就不去数据库查询了,防止 DB 宕机。
解释 2:大量请求查询一个刚刚失效的 key,导致 DB 压力倍增,可能导致宕机,但实际上,查询的都是相同的数据。
解决方案:可以在这些请求代码加上双重检查锁。但是那个阶段的请求会变慢。不过总比 DB 宕机好。
什么是缓存并发竞争?怎么解决?
解释:多个客户端写一个 key,如果顺序错了,数据就不对了。但是顺序我们无法控制。
解决方案:使用分布式锁,例如 zk,同时加入数据的时间戳。同一时刻,只有抢到锁的客户端才能写入,同时,写入时,比较当前数据的时间戳和缓存中数据的时间戳。
####什么是缓存和数据库双写不一致?怎么解决?
解释:连续写数据库和缓存,但是操作期间,出现并发了,数据不一致了。
通常,更新缓存和数据库有以下几种顺序:
- 先更新数据库,再更新缓存。
- 先删缓存,再更新数据库。
- 先更新数据库,再删除缓存。
三种方式的优劣来看一下:
先更新数据库,再更新缓存
这么做的问题是:当有 2 个请求同时更新数据,那么如果不使用分布式锁,将无法控制最后缓存的值到底是多少。也就是并发写的时候有问题。
先删缓存,Redis 面试常见问答再更新数据库
这么做的问题:如果在删除缓存后,有客户端读数据,将可能读到旧数据,并有可能设置到缓存中,导致缓存中的数据一直是老数据。
有 2 种解决方案:
- 使用“双删”,即删更删,最后一步的删除作为异步操作,就是防止有客户端读取的时候设置了旧值。
- 使用队列,当这个 key 不存在时,将其放入队列,串行执行,必须等到更新数据库完毕才能读取数据。
总的来讲,比较麻烦。
先更新数据库,再删除缓存
这个实际是常用的方案,但是有很多人不知道,这里介绍一下,这个叫 Cache Aside Pattern,老外发明的。如果先更新数据库,再删除缓存,那么就会出现更新数据库之前有瞬间数据不是很及时。
同时,如果在更新之前,缓存刚好失效了,读客户端有可能读到旧值,然后在写客户端删除结束后再次设置了旧值,非常巧合的情况。
有 2 个前提条件:
- 缓存在写之前的时候失效,同时,在写客户度删除操作结束后,放置旧数据 —— 也就是读比写慢。
- 设置有的写操作还会锁表
所以,这个很难出现,但是如果出现了怎么办?使用双删!!!记录更新期间有没有客户端读数据库,如果有,在更新完数据库之后,执行延迟删除。
还有一种可能,如果执行更新数据库,准备执行删除缓存时,服务挂了,执行删除失败怎么办???
这就坑了!!!不过可以通过订阅数据库的 binlog 来删除。
谈谈 Redis 的过期策略
在日常开发中,我们使用 Redis 存储 key 时通常会设置一个过期时间,但是 Redis 是怎么删除过期的 key,而且 Redis 是单线程的,删除 key 会不会造成阻塞。要搞清楚这些,就要了解 Redis 的过期策略和内存淘汰机制。
Redis 采用的是定期删除 + 懒惰删除策略。
定期删除策略
Redis 会将每个设置了过期时间的 key 放入到一个独立的字典中,默认每 100ms 进行一次过期扫描:
- 随机抽取 20 个 key
- 删除这 20 个 key 中过期的 key
- 如果过期的 key 比例超过 1/4,就重复步骤 1,继续删除。
为什不扫描所有的 key?
Redis 是单线程,全部扫描岂不是卡死了。而且为了防止每次扫描过期的 key 比例都超过 1/4,导致不停循环卡死线程,Redis 为每次扫描添加了上限时间,默认是 25ms。
如果客户端将超时时间设置的比较短,比如 10ms,那么就会出现大量的链接因为超时而关闭,业务端就会出现很多异常。而且这时你还无法从 Redis 的 slowlog 中看到慢查询记录,因为慢查询指的是逻辑处理过程慢,不包含等待时间。
如果在同一时间出现大面积 key 过期,Redis 循环多次扫描过期词典,直到过期的 key 比例小于 1/4。这会导致卡顿,而且在高并发的情况下,可能会导致缓存雪崩。
为什么 Redis 为每次扫描添的上限时间是 25ms,还会出现上面的情况?
因为 Redis 是单线程,每个请求处理都需要排队,而且由于 Redis 每次扫描都是 25ms,也就是每个请求最多 25ms,100 个请求就是 2500ms。
如果有大批量的 key 过期,要给过期时间设置一个随机范围,而不宜全部在同一时间过期,分散过期处理的压力。
从库的过期策略
从库不会进行过期扫描,从库对过期的处理是被动的。主库在 key 到期时,会在 AOF 文件里增加一条 del 指令,同步到所有的从库,从库通过执行这条 del 指令来删除过期的 key。
因为指令同步是异步进行的,所以主库过期的 key 的 del 指令没有及时同步到从库的话,会出现主从数据的不一致,主库没有的数据在从库里还存在。
懒惰删除策略
Redis 为什么要懒惰删除(lazy free)?
删除指令 del 会直接释放对象的内存,大部分情况下,这个指令非常快,没有明显延迟。不过如果删除的 key 是一个非常大的对象,比如一个包含了千万元素的 hash,又或者在使用 FLUSHDB 和 FLUSHALL 删除包含大量键的数据库时,那么删除操作就会导致单线程卡顿。
redis 4.0 引入了 lazyfree 的机制,它可以将删除键或数据库的操作放在后台线程里执行, 从而尽可能地避免服务器阻塞。
unlink
unlink 指令,它能对删除操作进行懒处理,丢给后台线程来异步回收内存。
1 | |
flush
flushdb 和 flushall 指令,用来清空数据库,这也是极其缓慢的操作。Redis 4.0 同样给这两个指令也带来了异步化,在指令后面增加 async 参数就可以将整棵大树连根拔起,扔给后台线程慢慢焚烧。
1 | |
异步队列
主线程将对象的引用从「大树」中摘除后,会将这个 key 的内存回收操作包装成一个任务,塞进异步任务队列,后台线程会从这个异步队列中取任务。任务队列被主线程和异步线程同时操作,所以必须是一个线程安全的队列。
不是所有的 unlink 操作都会延后处理,如果对应 key 所占用的内存很小,延后处理就没有必要了,这时候 Redis 会将对应的 key 内存立即回收,跟 del 指令一样。
更多异步删除点
Redis 回收内存除了 del 指令和 flush 之外,还会存在于在 key 的过期、LRU 淘汰、rename 指令以及从库全量同步时接受完 rdb 文件后会立即进行的 flush 操作。
Redis4.0 为这些删除点也带来了异步删除机制,打开这些点需要额外的配置选项。
- slave-lazy-flush 从库接受完 rdb 文件后的 flush 操作
- lazyfree-lazy-eviction 内存达到 maxmemory 时进行淘汰
- lazyfree-lazy-expire key 过期删除
- lazyfree-lazy-server-del rename 指令删除 destKey
内存淘汰机制
Redis 的内存占用会越来越高。Redis 为了限制最大使用内存,提供了 redis.conf 中的
配置参数 maxmemory。当内存超出 maxmemory,Redis 提供了几种内存淘汰机制让用户选择,配置 maxmemory-policy:
- noeviction:当内存超出 maxmemory,写入请求会报错,但是删除和读请求可以继续。(使用这个策略,疯了吧)
- allkeys-lru:当内存超出 maxmemory,在所有的 key 中,移除最少使用的 key。只把 Redis 既当缓存是使用这种策略。(推荐)。
- allkeys-random:当内存超出 maxmemory,在所有的 key 中,随机移除某个 key。(应该没人用吧)
- volatile-lru:当内存超出 maxmemory,在设置了过期时间 key 的字典中,移除最少使用的 key。把 Redis 既当缓存,又做持久化的时候使用这种策略。
- volatile-random:当内存超出 maxmemory,在设置了过期时间 key 的字典中,随机移除某个 key。
- volatile-ttl:当内存超出 maxmemory,在设置了过期时间 key 的字典中,优先移除 ttl 小的。
LRU 算法
实现 LRU 算法除了需要 key/value 字典外,还需要附加一个链表,链表中的元素按照一定的顺序进行排列。当空间满的时候,会踢掉链表尾部的元素。当字典的某个元素被访问时,它在链表中的位置会被移动到表头。所以链表的元素排列顺序就是元素最近被访问的时间顺序。
使用 Python 的 OrderedDict(双向链表 + 字典) 来实现一个简单的 LRU 算法:
1 | |
近似 LRU 算法
Redis 使用的并不是完全 LRU 算法。不使用 LRU 算法,是为了节省内存,Redis 采用的是随机 LRU 算法,Redis 为每一个 key 增加了一个 24 bit 的字段,用来记录这个 key 最后一次被访问的时间戳。
注意 Redis 的 LRU 淘汰策略是懒惰处理,也就是不会主动执行淘汰策略,当 Redis 执行写操作时,发现内存超出 maxmemory,就会执行 LRU 淘汰算法。这个算法就是随机采样出 5(默认值)个 key,然后移除最旧的 key,如果移除后内存还是超出 maxmemory,那就继续随机采样淘汰,直到内存低于 maxmemory 为止。
如何采样就是看 maxmemory-policy 的配置,如果是 allkeys 就是从所有的 key 字典中随机,如果是 volatile 就从带过期时间的 key 字典中随机。每次采样多少个 key 看的是 maxmemory_samples 的配置,默认为 5。
LFU
Redis 4.0 里引入了一个新的淘汰策略 —— LFU(Least Frequently Used) 模式,作者认为它比 LRU 更加优秀。
LFU 表示按最近的访问频率进行淘汰,它比 LRU 更加精准地表示了一个 key 被访问的热度。
如果一个 key 长时间不被访问,只是刚刚偶然被用户访问了一下,那么在使用 LRU 算法下它是不容易被淘汰的,因为 LRU 算法认为当前这个 key 是很热的。而 LFU 是需要追踪最近一段时间的访问频率,如果某个 key 只是偶然被访问一次是不足以变得很热的,它需要在近期一段时间内被访问很多次才有机会被认为很热。
Redis 对象的热度
Redis 的所有对象结构头中都有一个 24bit 的字段,这个字段用来记录对象的热度。
1 | |
LRU 模式
在 LRU 模式下,lru 字段存储的是 Redis 时钟 server.lruclock,Redis 时钟是一个 24bit 的整数,默认是 Unix 时间戳对 2^24 取模的结果,大约 97 天清零一次。当某个 key 被访问一次,它的对象头的 lru 字段值就会被更新为 server.lruclock。
LFU 模式
在 LFU 模式下,lru 字段 24 个 bit 用来存储两个值,分别是 ldt(last decrement time) 和 logc(logistic counter)。
logc 是 8 个 bit,用来存储访问频次,因为 8 个 bit 能表示的最大整数值为 255,存储频次肯定远远不够,所以这 8 个 bit 存储的是频次的对数值,并且这个值还会随时间衰减。如果它的值比较小,那么就很容易被回收。为了确保新创建的对象不被回收,新对象的这 8 个 bit 会初始化为一个大于零的值,默认是 LFU_INIT_VAL=5。
ldt 是 16 个位,用来存储上一次 logc 的更新时间,因为只有 16 位,所以精度不可能很高。它取的是分钟时间戳对 2^16 进行取模,大约每隔 45 天就会折返。
同 LRU 模式一样,我们也可以使用这个逻辑计算出对象的空闲时间,只不过精度是分钟级别的。图中的 server.unixtime 是当前 redis 记录的系统时间戳,和 server.lruclock 一样,它也是每毫秒更新一次。